Wenn Sie gerade das Budget für 2027 planen, liegen vielleicht drei Papiere vor Ihnen: das Angebot einer KI-Suite für Content, ein interner Vorschlag, etwas Eigenes aufzubauen, und das Angebot eines Content-KI-Dienstleisters. Der naheliegende Vergleich, Funktionsliste gegen Funktionsliste und Monatspreis gegen Tagessatz, führt in die Irre. Ob Sie eine Suite kaufen, selbst bauen oder einen Dienstleister beauftragen sollten, lässt sich für die Content-Produktion als Ganzes kaum beantworten. Zerlegen Sie die Produktion dagegen in drei Schichten, lässt sich die Frage für jede einzeln beantworten. Die erste Schicht ist die Technik aus Sprachmodellen und Werkzeugen. Darauf baut der Ablauf mit seinen Übergaben auf, und ganz oben liegen die Prüfregeln samt dem Fachwissen, aus dem ein Text entsteht.
Ich schreibe diesen Beitrag aus der Praxis und mit eigenem Interesse, denn PR DESK ist selbst ein solcher Dienstleister. In unserer Werkstatt haben wir beides getan: Sprachmodelle und Werkzeuge kaufen wir meist als Abo oder nach Verbrauch, den Ablauf, die Prüfregeln und die Ordnung unseres Fachwissens haben wir selbst gebaut. Dieser Beitrag zeigt, was jede Schicht in unserem Betrieb umfasst, wie schnell sie sich ändert und was uns die Werkzeuge in Geld und der Ablauf in Zeit kosten. Dazu kommen drei Kriterien, mit denen Sie je Schicht für 2027 entscheiden, ob Sie kaufen, bauen oder einen Dienstleister beauftragen.
Drei Schichten, drei getrennte Entscheidungen
Nach unserer Beobachtung stellen viele Angebote für KI-Content ein Werkzeug in den Vordergrund, etwa ein Sprachmodell oder eine Plattform. Was eine Content-Produktion trägt, reicht aber weiter. Hier die drei Schichten im Einzelnen:
- Modell und Werkzeug: Sprachmodelle, Recherche- und Datendienste, Ablage, Hosting der Website.
- Ablauf und Übergaben: wer welchen Arbeitsschritt erledigt, wer an wen übergibt und wer einen Text stoppen darf.
- Prüfregeln und Fachwissen: die Standards, an denen ein Text gemessen wird, und das Wissen über Branche, Quellen und Kunden, aus dem er entsteht.
Zwei Grundfragen beantworten wir in eigenen Beiträgen, damit dieser Text bei der Kaufentscheidung bleiben kann. Wie eine Content Pipeline aufgebaut ist, beschreibt der Beitrag Was ist eine Content Pipeline?. Welche Arbeit die Maschine übernehmen darf und wo ein Mensch entscheidet, steht im Beitrag KI-Content: Was Maschinen im B2B übernehmen dürfen und was Menschen entscheiden müssen. Hier geht es um eine andere Trennlinie: welche Schicht Sie besitzen sollten und welche Sie besser mieten.
Entschieden wird je Schicht an drei Kriterien:
- Änderungstempo: Wie oft müssen Sie die Schicht ersetzen oder umbauen? Anlässe sind etwa ein besseres Modell, ein eingestelltes Werkzeug oder eine veränderte Arbeitsweise.
- Kontext: Wie viel von Ihrem Urteil und Ihrem Wissen über Kunden und Markt steckt darin, und was geht bei einem Wechsel verloren?
- Prüfbarkeit: Können Sie selbst kontrollieren, ob die Schicht ihre Arbeit tut?
Die Antworten fallen je Schicht verschieden aus. Unsere eigenen Zahlen zeigen, wie verschieden. Die nachfolgenden Kosten stammen aus unserer Kalkulation und nicht aus einzelnen Rechnungen, meine eigenen Zeiten sind Angaben aus dem Betrieb und keine Erfassung auf die Minute.
Schicht 1: Neue Modelle messen wir für Cent-Beträge
Zuerst die Kosten, damit Sie die Größenordnung kennen. Unsere Werkzeuge kosten im Monat 271 Euro, alle Beträge hier netto. Den größten Teil, 246 Euro, tragen KI-Dienste und Suchdaten: das Max-Abo von Claude für 90 Euro, vier weitere KI-Abos (ChatGPT, Perplexity, Gemini und Grok) für zusammen 150 Euro und im Mittel rund 6 Euro für Suchdaten von DataForSEO, abgerechnet nach Verbrauch. Der Rest entfällt auf das Hosting der Website bei STRATO mit rund 15 Euro und auf Microsoft OneDrive als Ablage mit 10 Euro. Notion und Raindrop nutzen wir kostenlos. Zwei Werkzeuge haben wir wieder aus dem Betrieb genommen: Semrush und HeyGen.
Für Ihre Planung 2027 heißt das: Nach unserem Kostenstand von Oktober 2026 kostet diese Schicht wenig, und sie ist der beweglichste Teil der Produktion.
Wie beweglich, hat uns ein Textvergleich für unsere Leistungsseite gezeigt. Den maschinellen Rohtext dafür hatten wir am 18. September 2026 mit GPT-4o mini erzeugt, in der Modellversion vom 18. Juli 2024. Sechs Tage später haben wir mit zwei aktuellen Modellen neu gemessen, je drei Läufe. Ein Lauf kostete bei GPT-5.5 rund einen halben US-Cent, bei Gemini 3.8 Flash unter 0,2 Cent, alle sechs Läufe zusammen gut zwei Cent. Wir prüften die neuen Texte mit demselben Prüfskript wie den alten. Das Modell war austauschbar, die Prüfung blieb. Die Arbeitszeit für den Wechsel haben wir nicht gemessen.
Dass die Lebensdauer von Werkzeugen auch Käufer umtreibt, deutet eine Befragung aus dem DACH-Raum an. Für die Studie „Software Buying in DACH 2026“ befragten OMR Reviews und CSE Advisory knapp 200 Softwarekäufer in Deutschland, Österreich und der Schweiz. Rund 60 Prozent nennen die Unsicherheit über den Ertrag, die Lebensdauer von Werkzeugen und sich schnell entwickelnde Märkte als ihre größten Sorgen. Die Studie weist die drei Antworten in einer Zahl aus, und OMR Reviews betreibt selbst eine Bewertungsplattform für Software. Für den Kauf einer Suite heißt das: Neben den Preis gehört gleichrangig die Frage, wie lange sich ein Tool sinnvoll einsetzen lässt.
Schicht 2: Der Ablauf altert leise
Der Ablauf legt fest, welche Stufe was liefert, wer übergibt und wer stoppen darf. Veraltet er, meldet sich kein Werkzeug. Ein schwaches Modell erkennen Sie am Text, eine ausgefallene Übergabe sehen Sie dem Text nicht an. In zwei Beiträgen, deren Arbeitsgänge wir erfasst haben, schrieb die Maschine den Entwurf in Minuten, Prüfung und Freigabe dauerten ein Vielfaches. Für unseren Beitrag KI-Einheitstext vermeiden brauchte der Entwurf 9 Minuten 30 Sekunden, die maschinelle Prüfung und Korrektur 18 Minuten 14 Sekunden, meine Lektüre bis zur Freigabe 42 Minuten. Was diese Verteilung für den eigenen Ablauf bedeutet, steht im Beitrag Content-Erstellung mit KI: Welche Schritte Ihr Ablauf halten muss.
Was ein unpassender Ablauf kostet, hat uns Anfang Oktober ein einzelner Beitrag vorgeführt. Für unseren Text über Googles Einschätzung zum manuellen Faktencheck bei KI-Content zog sich allein die Produktionsstufe mit Wartezeiten über rund drei Stunden. Die Faktenprüfung der Endfassung lief über neun Durchgänge, eine erste Fassung hatte vorher schon fünf gebraucht. Das liegt über der Obergrenze von fünf Prüfdurchgängen, die wir sonst ansetzen. Ab dem vierten Durchgang der Endfassung ging es fast nur noch um die Lesart einzelner Sätze. Meine aktive Zeit für den ganzen Beitrag, über alle Stufen, schätze ich auf 55 Minuten. Den größten Teil der drei Stunden habe ich also gewartet. Mein Fazit an jenem Abend: „Solche Mammut-Sitzungen rechnen sich nicht.“ Noch am selben Abend haben wir den Ablauf der Faktenprüfung geändert.
Wie leise ein Ablauf veralten kann, zeigte eine Durchsicht unserer Unterlagen am 1. Oktober. Fünf automatische Aufgaben waren abgeschaltet, während unsere Unterlagen sie als laufend führten: die wöchentlichen Auswertungen von Podcasts, YouTube, einem Fachmedium und unseren Lesezeichen sowie die Pflege unserer Liste offener Punkte. Ihr letzter Lauf lag zwischen drei und zehn Tagen zurück. Ab der Folgewoche wären aus diesen Quellen keine Themenvorschläge mehr gekommen, und die Liste offener Punkte wäre nicht mehr gepflegt worden. Bemerkt hatte das bis dahin niemand. Wie an der Bushaltestelle: Der Aushang hängt noch, der Bus fährt nicht mehr.
Schicht 3: Das Regelwerk wächst, bis wir streichen
In der dritten Schicht steckt, woran ein Text gemessen wird, bevor er erscheint, und das Wissen, aus dem er entsteht. Bei uns gehört dazu ein selbst geschriebenes Prüfskript, inzwischen in Version 1.6.0. Es prüft unsere Texte vor der Freigabe auf sprachliche Muster. Dazu kommen die Regelwerke für Stimme, Sprache, Ablauf und Prüfung und eine Evidenz-Landkarte. Das ist unser Verzeichnis der Quellen, auf die wir uns stützen. Zu jeder Quelle halten wir dort fest: wie belastbar sie ist, wann ihre Daten erhoben wurden und ob wir sie schon in einem Beitrag verwendet haben. Auch unbelegte oder widerlegte Zahlen bleiben dort verzeichnet, damit wir sie kein zweites Mal prüfen oder verwenden.
Anfang Oktober 2026 haben wir nachgezählt, wie viel Regelwerk an einem einzigen Wissensbeitrag hängt. Allein die vier Regelwerke, die beim Schreiben geladen werden, hatten zusammen 14.537 Wörter, darunter das Regelwerk für den Ablauf aus Schicht 2, dazu kamen Projektanweisungen, Vorlagen und das Briefing. In den beiden Regelwerken zu Stimme und Sprache standen am 7. Oktober 97 Stellen, die etwas verbieten oder begrenzen. Die vier Regelwerke haben rund sechsmal so viele Wörter wie dieser Beitrag. Unser eigener Befund vom 7. Oktober: „Das Regelwerk wächst nur.“ Jeder Fehlerfall war zur dauerhaften Regel geworden. Zwei Tage später haben wir sechs Prüfregeln gestrichen, für die kein Anlass dokumentiert war.
Ich halte diese Schicht trotzdem für die wertvollste unserer Werkstatt. Ein Werkzeug können Sie sich leihen wie eine Bohrmaschine. Wo in Ihrer Wand die Leitungen liegen, weiß der Verleih nicht.
Welche Schicht wir mieten und welche wir selbst halten
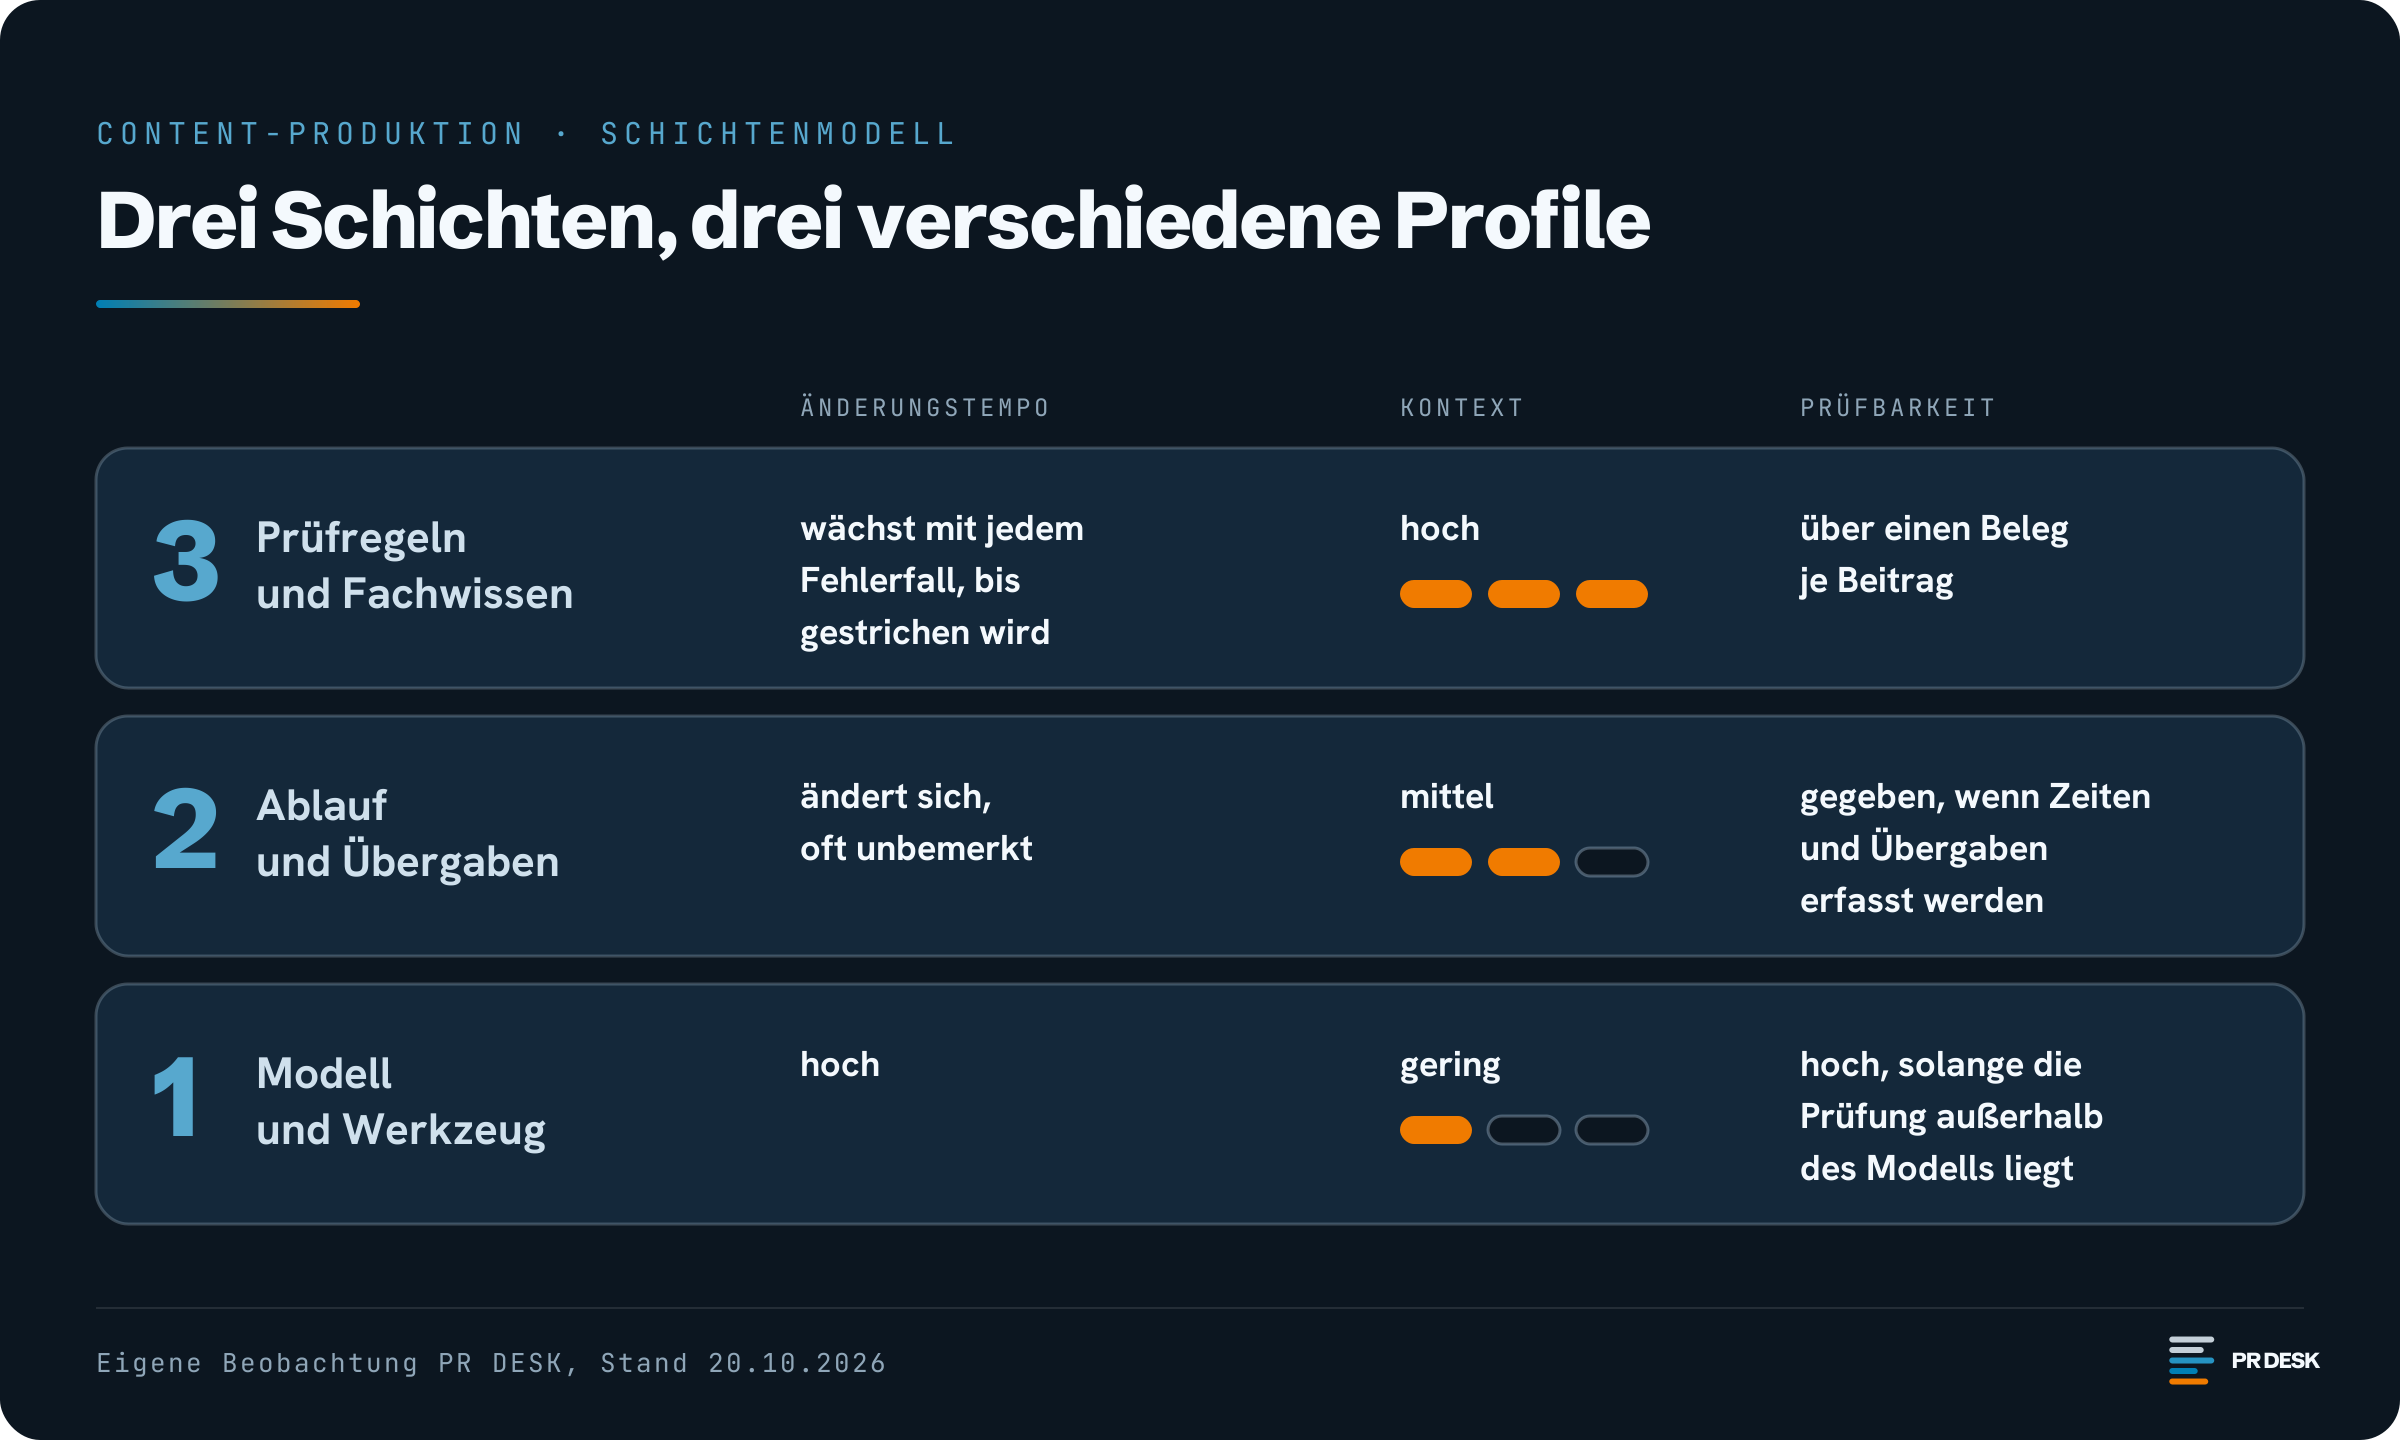
Wie schneiden die drei Schichten nun ab? Die Tabelle zeigt, was wir in unserer eigenen Content-Produktion beobachten. Eine allgemeine Messung ist das nicht.
| Kriterium | Modell und Werkzeug | Ablauf und Übergaben | Prüfregeln und Fachwissen |
|---|---|---|---|
| Änderungstempo | hoch | ändert sich, oft unbemerkt | wächst mit jedem Fehlerfall, bis wir streichen |
| Kontext | gering | mittel: Hier ist festgelegt, wer einen Text stoppen darf | hoch: Urteil, Quellen- und Kundenwissen |
| Prüfbarkeit | hoch, solange die Prüfung außerhalb des Modells liegt | gegeben, wenn Zeiten und Übergaben erfasst werden | über einen Beleg je Beitrag, welche Aussage gegen welche Quelle geprüft wurde |
Für unsere eigene Content-Produktion folgt daraus eine klare Aufteilung. Den größten Teil der ersten Schicht mieten wir und wechseln ihn, wenn ein besseres Modell kommt. Selbst halten wir die dritte Schicht, weil in ihr steckt, was bei einem Wechsel verloren ginge. Die mittlere Schicht ist der Verhandlungsraum: Sie kann bei Ihnen liegen, bei einem Dienstleister oder in einer Suite, solange Sie sehen, wo ein Mensch entscheidet.
Wer daraus schließt, Selbstbauen sei grundsätzlich die bessere Wahl, sollte eine Zahl aus dem Bericht „The GenAI Divide: State of AI in Business 2025“ von MIT NANDA kennen. Die Autoren berichten aus ihrer Interview-Stichprobe mit 52 Organisationen: Partnerschaften mit externen Anbietern lernfähiger, angepasster Werkzeuge kamen in rund 67 Prozent der Fälle in den Einsatz, intern gebaute Werkzeuge in rund 33 Prozent. Die Autoren schränken selbst ein: Die Zahlen beruhen auf Angaben der Befragten, und der Abstand kann auch an den Fähigkeiten der Organisationen liegen, nicht allein am gewählten Weg.
Ich lese den Bericht als Argument dafür, Werkzeuge einzukaufen, die sich an den eigenen Ablauf anpassen lassen. Den Ausschlag gibt für mich weniger der Abstand der Prozentwerte als das, was die Autoren über die erfolgreichen Käufer berichten: Sie verlangten, dass sich ein Werkzeug tief an ihre Abläufe und Daten anpassen lässt. Als Hauptgrund für das Scheitern nennen die Autoren Werkzeuge mit drei Schwächen: Sie lernen nicht dazu, lassen sich schlecht einbinden oder passen nicht zu den Abläufen. Das passt zu unserer Aufteilung: Werkzeug zukaufen, das eigene Urteil behalten.
Meine Einschätzung: Die Content-Produktion ist ein Handwerk. Buchstaben aneinanderkleben kann fast jeder, aber Botschaften, die Zielgruppen erreichen und bei ihnen etwas auslösen, zu formulieren, ist harte Arbeit. Ein Teil davon lässt sich automatisieren, jedoch nur, wenn die Grundlagen stimmen. Gemeint sind Prüfregeln und Fachwissen. Sie sind erfolgskritisch.
Content-KI-Dienstleister 2027: Welche Schichten Sie abgeben können
Zurück zu den drei Angeboten vom Anfang: der KI-Suite, dem Eigenbau und dem Content-KI-Dienstleister. Die dritte Möglichkeit ist unser Geschäftsmodell. Deshalb lege ich an sie dieselben drei Kriterien an und nenne vorher das Eigeninteresse: PR DESK verdient Geld damit, dass Unternehmen Content-Produktion bei uns einkaufen.
Was ein Dienstleister abnehmen kann, ist zuerst Kapazität. Dazu liefert die OMR-Studie aus Schicht 1 eine Zahl: 42 Prozent der Befragten aus Unternehmen mit 51 bis 200 Beschäftigten nennen fehlende Kapazität als Grund, beim Softwarekauf externe Berater oder Agenturen einzubinden. Die Frage dort betrifft den Kauf von Software und nicht die Produktion von Content. Die Studie liest daraus, dass das Fachwissen im Haus ist und die Hände fehlen. Wir beziehen die Zahl trotzdem auf uns. Als Dienstleister konkurrieren wir unter anderem mit automatisierten Content-Werkzeugen, und bei vielen davon fehlt nach unserer Beobachtung der Mensch, der vor der Veröffentlichung prüft (Human in the Loop).
Was heißt das für die Zusammenarbeit mit einem Content-KI-Dienstleister? Für jede Schicht etwas anderes:
- Schicht 1, Modell und Werkzeug, kann der Dienstleister tragen, samt dem Aufwand für jeden Modellwechsel. Fragen Sie, wie er Modelle wechselt und woran er misst, ob ein neues besser ist.
- Schicht 2, Ablauf und Übergaben, kann er für Sie betreiben. Bestehen Sie darauf, zu sehen, wo ein Mensch entscheidet und wer einen Text stoppen darf.
- Schicht 3, Prüfregeln und Fachwissen, zerfällt beim Einkauf in zwei Teile. Die Prüfregeln sind das Handwerk des Dienstleisters. Ihr Fachwissen über Kunden, Begriffe und Positionierung bleibt Ihres.
Wir halten es selbst so: Die vollständige Prüfliste legen wir nicht offen, sie ist unser Handwerk. Einzelne Beispiele zeigen wir. Prüfbar machen lässt sich die Schicht trotzdem. Ein Dienstleister kann Ihnen je Beitrag zeigen, welche Aussagen gegen welche Quelle geprüft wurden, ohne seine Prüfliste offenzulegen. Wie das aussieht, zeigt ein Beispiel auf unserer Seite zur Content Pipeline unter „Prüfung 2 · Fakten“. Dort sehen Sie an einer Aussage aus einem veröffentlichten Beitrag, gegen welche Quellen wir sie geprüft haben und welcher Fehler möglich gewesen wäre.
Prüffragen für die Budgetrunde 2027
Drei Schritte machen die Angebote auf Ihrem Tisch vergleichbar:
- Zerlegen Sie jedes Angebot in die drei Schichten. Notieren Sie, welche Schicht der Anbieter liefert, welche Sie selbst halten und welche niemand ausdrücklich übernimmt.
- Beantworten Sie je Schicht die drei Fragen. Wie oft müssen Sie sie ersetzen oder umbauen? Wie viel Ihres Wissens steckt darin? Können Sie selbst nachprüfen, ob sie funktioniert? Oder müssen Sie dem Anbieter glauben?
- Vergleichen Sie Schicht mit Schicht. Eine Suite mit dem besseren Modell gewinnt Schicht 1 und sagt noch nichts über Schicht 3.
Achten Sie besonders auf die Schicht, die niemand ausdrücklich übernimmt. In ihr ist niemand zuständig, einen Fehler zu stoppen. Ein Beispiel: Die Suite liefert das Modell, die Agentur schreibt den Text, Ihr Team gibt ihn frei. Ob eine Pflicht aus der KI-Verordnung (oder eine andere kritische Tatsachenangabe) im Text richtig wiedergegeben ist, hält jeder der drei für die Aufgabe eines anderen. Dann erscheint unter Ihrem Namen ein Absatz, der die Betreiber statt der Anbieter verpflichtet. Genau dieser Fehler wäre in dem Beitrag möglich gewesen, aus dem unser Beispiel unter „Prüfung 2 · Fakten“ stammt.
Beim Einkauf schon das Vertragsende regeln
Über das Ende einer Zusammenarbeit spricht beim Einkauf kaum jemand gern. Es lohnt sich trotzdem, denn vor der Unterschrift verhandeln Sie aus der stärkeren Position, beim Ausstieg nicht mehr. Deshalb gehört eine Frage in jeden Vertrag, ob für Suite, Eigenbau oder Dienstleister: Was bleibt bei Ihnen, wenn die Zusammenarbeit endet, und was kostet Sie ein Wechsel in Geld und Stunden?
Für Schicht 1 ist die Antwort harmlos. Modelle und Werkzeuge kaufen Sie bei einem Wechsel ohnehin neu, und eine kurze Laufzeit passt zu ihrem Tempo. Für Schicht 3 entscheidet die Antwort über das Jahr 2027 hinaus. Ihre Begriffe, Ihre Freigabekriterien, Ihr Wissen über Kunden und die Quellen, auf die Sie sich stützen, gehören in eine Form, die Sie ohne den Anbieter lesen und weitergeben können. Wir halten es in unserem eigenen Angebot so: Die Content Pipeline ist monatlich kündbar, und alles, was bis dahin entstanden ist, bleibt beim Kunden, von der Themenarchitektur über Strategien bis zu Inhalten und freigegebenen Assets. Legen Sie das fest, bevor Sie unterschreiben.
Recherche und Erstentwurf stammen von einer KI. Ich habe an zwei festen Gates geprüft und entschieden. Die Faktenvalidierung hat 80 Aussagen gegen ihre Quellen abgeglichen, den fertigen Text habe ich selbst freigegeben.
Quellen: MIT NANDA, „The GenAI Divide: State of AI in Business 2025“, Juli 2025, S. 10 und 18 bis 20, Kopie bei Webber Wentzel · OMR Reviews × CSE Advisory, „Software Buying in DACH 2026“, S. 7, 35 und 36 · Eigene Betriebsdaten PR DESK: Werkzeugkalkulation (Stand 02.10.2026), Angebot und Eigentumsregel auf prdesk.de/content-pipeline/ (Stand 20.10.2026), Messprotokoll Textvergleich Leistungsseite (18. und 24.09.2026), Durchsicht der Unterlagen (01.10.2026), Zählung der Regelwerke (07.10.2026), Werkstatt-Protokoll (09.10.2026), Baseline-Daten der Beiträge „KI-Einheitstext vermeiden“ und „Google hält den manuellen Faktencheck bei KI-Content für entscheidend“
Aus Ihrem Fachwissen wird ein Content-System. Lassen Sie uns klären, welches Thema Ihre erste Content Pipeline trägt. Erstgespräch vereinbaren →