Seit dem 1. Oktober 2026 steht in Googles Leitfaden zu KI-generierten Inhalten ein neuer Satz: Es sei „critical“, also entscheidend, KI-generierte Inhalte vor der Veröffentlichung manuell zu prüfen. Den Leitfaden gab es schon vorher, Google hat ihn an diesem Tag überarbeitet. Title-Elemente, Meta-Beschreibungen, strukturierte Daten und Alt-Texte nannte er schon früher. Neu ist, dass sie jetzt ausdrücklich unter diese Prüfung fallen. Der Faktencheck für KI-Content endet damit nicht beim letzten Textabsatz.
Für Content-Marketing und SEO hat das Gewicht. Der Leitfaden steht in Google Search Central, Googles Dokumentation zur Suchmaschinenoptimierung von Websites, und beschreibt, wie Google KI-generierte Inhalte auf Websites sieht. Zur Erinnerung: Die genannten Felder können in den Suchergebnissen erscheinen, noch bevor jemand Ihre Webseite öffnet. Füllt bei Ihnen ein Plugin oder ein LLM automatisch Title und Meta-Beschreibung aus, nachdem der Text freigegeben ist, bleiben diese Felder womöglich ungeprüft. Stimmen dann ein Fakt oder eine Zahl in der Meta-Beschreibung nicht, können diese Informationen dann trotzdem im Suchergebnis unter Ihrem Namen erscheinen. Peinlich!
Dieser Beitrag zeigt, was Googles Leitfaden jetzt genau fordert. Dazu liefern wir unsere Prüfobjekt-Matrix, ein eigenes Modell von PR DESK, für Title-Element, Meta-Beschreibung, strukturierte Daten und Alt-Text. Damit sehen Sie, an welcher Stelle Ihres Ablaufs noch ein Prüfer fehlt.
Faktencheck KI-Content: Was Googles KI-Leitfaden seit dem 1. Oktober 2026 sagt
Der KI-Leitfaden von Google heißt im Original „Google Search’s guidance on using generative AI content on your website“. Im Abschnitt zu Richtigkeit, Qualität und Relevanz steht seit dem 1. Oktober 2026 dieser Satz: „It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing.“ Eigene Übersetzung: Es ist entscheidend, alle KI-generierten Inhalte vor der Veröffentlichung manuell auf Richtigkeit und Vertrauenswürdigkeit zu prüfen.
Die Begründung für diese Prüfung liefert Google im selben Absatz. Generative Modelle, schreibt Google, „don’t retrieve facts, but predict a likely sequence of words based on their training data“. Eigene Übersetzung: Die Modelle rufen keine Fakten ab, sie sagen auf Basis ihrer Trainingsdaten eine wahrscheinliche Wortfolge voraus. Deshalb könnten KI-Ausgaben Ungenauigkeiten enthalten, die Google Halluzinationen nennt. Ein Modell liefert also flüssige Sätze, aber flüssig heißt noch nicht geprüft. Das gilt für einen Absatz im Fließtext genauso wie für eine kurze Meta-Beschreibung.
Direkt an den Prüfsatz schließt Google den Satz zu den Metadaten an: „This review also applies to metadata like <title> elements, meta description elements, structured data, and alternate texts for images, which can appear in Search results.“ Eigene Übersetzung: Diese Prüfung gilt auch für Metadaten wie Title-Elemente, Meta-Beschreibungen, strukturierte Daten und Alternativtexte für Bilder, die in den Suchergebnissen erscheinen können.
Gemeint sind der Seitentitel und die Kurzbeschreibung im Code der Seite, die strukturierten Daten und die Alternativtexte, die ein Bild in Worten beschreiben. Die deutsche Fassung des Leitfadens (Stand 31. Dezember 2025) nennt dieselben Metadaten schon, dort noch als Teil der Aufforderung, auf Richtigkeit, Qualität und Relevanz zu achten. Für die Praxis heißt das: Nach Googles KI-Leitfaden gehören auch Felder in diese Prüfung, die ein Plugin oder ein Modell nebenbei füllen kann.
Was passiert, wenn niemand prüft, lässt das Dokument offen. Aber eine Grenze zieht Google im ersten Absatz des Leitfadens trotzdem: Wer mit generativer KI viele Seiten ohne Mehrwert für Nutzer erzeugt, kann gegen Googles Spam-Richtlinie zu „scaled content abuse“ verstoßen, also zu massenhaft erzeugten Inhalten. Bei Verstößen gegen seine Spam-Richtlinien können Websites laut Google schlechter ranken oder gar nicht in den Ergebnissen erscheinen. Diese Grenze betrifft die Massenproduktion ohne Mehrwert. Auch bekannt als KI-Slop, in etwa so beliebt wie fortgeschrittene Karies. Einen einzelnen ungeprüften Fehler meint sie nicht. Bei einem solchen Fehler riskieren Sie praktisch etwas anderes: eine falsche Angabe im Text oder im Suchergebnis, die unter Ihrem Namen steht, und das Vertrauen der Leser, die sie entdecken.
Woher die Ergänzung vom 1. Oktober 2026 stammt, gibt Google im Änderungsprotokoll seiner Dokumentation an: aus den Search Quality Rater Guidelines. Das sind Googles Richtlinien für die sogenannten Rater. Rater sind nach Googles Darstellung Menschen, die Rückmeldung dazu geben, ob seine Algorithmen gute Ergebnisse liefern. Für viele SEOs sind die Guidelines so etwas wie die Bibel ihres Fachs. Weiter unten kommen sie noch einmal vor, weil Googles Leitfaden zu hilfreichen Inhalten ihren Maßstab für guten Inhalt aufgreift.
Wer den Faktencheck des KI-Contents übernehmen soll, lässt Googles Leitfaden offen
Aus Googles KI-Leitfaden nehmen Sie bitte zwei Dinge mit. Erstens hält Google alle KI-generierten Inhalte für prüfungsbedürftig, Metadaten eingeschlossen. Zweitens muss der Zeitpunkt dieser Prüfung vor der Veröffentlichung liegen. Wer prüfen soll, finden Sie dort nicht. Auch was „manually“ genau bedeutet, erklärt der Leitfaden nicht (Stand 1. Oktober 2026). Wer in Ihrem Ablauf prüft und wie gründlich, entscheiden damit Sie selbst. Die Verantwortung dafür tragen Sie ebenfalls.
Für strukturierte Daten nennt der Leitfaden konkrete Prüfschritte. Strukturierte Daten sind ein standardisiertes Format, das Suchmaschinen Informationen über eine Seite liefert und ihren Inhalt einordnet. Die Auszeichnung im Code heißt Markup. Das Markup soll validiert werden und zwei Regelwerke einhalten: die allgemeinen Richtlinien und die Richtlinien der einzelnen Suchfunktionen. Die allgemeinen Richtlinien für strukturierte Daten halten außerdem fest: „Don’t mark up content that is not visible to readers of the page.“ Eigene Übersetzung: Zeichnen Sie keine Inhalte aus, die Leser der Seite nicht sehen. Bei strukturierten Daten laufen damit zwei Prüfungen nebeneinander. Die eine prüft, ob das Markup technisch gültig ist. Die andere hält es gegen das, was tatsächlich auf der Seite steht.
Damit bleiben zwei Fragen bei Ihnen: Wer prüft Text und Metadaten, und an welcher Stelle im Ablauf entsteht jedes davon? Der Leitfaden nennt vier Metadaten als Beispiele: Title-Element, Meta-Beschreibung, strukturierte Daten und Alt-Text. In diesem Beitrag heißen sie Felder. Den Zeitpunkt der Prüfung gibt Google mit „before publishing“ vor. Googles KI-Leitfaden unterscheidet nicht, ob ein Feld vor oder nach der Freigabe des Textes entsteht. Genau hier setzt die Prüfobjekt-Matrix an.
Die Prüfobjekt-Matrix für den Faktencheck von KI-Content: ein Raster für Ersteller, Zeitpunkt und Prüfer
Die Prüfobjekt-Matrix ist ein eigenes Modell von PR DESK und kein Teil von Googles Dokumentation. Wir haben sie für diesen Beitrag aus unserem Produktionsablauf abgeleitet, damit Sie Googles Liste neben Ihren eigenen Ablauf legen können.
Die Matrix ordnet fünf Prüfobjekten je vier Angaben zu. Gemeint sind der Haupttext und die vier Metadaten, die der Satz zu den Metadaten im KI-Leitfaden ausdrücklich aufführt: Title-Element, Meta-Beschreibung, strukturierte Daten und Alt-Text. Die vier Angaben je Objekt lauten: wer es erzeugt, ob es vor oder nach dem Text-Gate entsteht, wie es geprüft wird und wer prüft. Hängt der Zeitpunkt vom Ablauf ab oder ist der Prüfer offen, steht das ausdrücklich in der Zelle.
Ein Gate ist ein fester Prüfpunkt im Ablauf, an dem nichts ohne Freigabe weitergeht, zumindest bei uns. Das Text-Gate ist der Punkt, an dem der fertige Text freigegeben wird. Warum ein solcher Punkt dort sitzen muss, wo ein Fehler teuer wird, steht in unserem Beitrag zum Human in the Loop. Nach welcher Regel ein Schritt an die Maschine geht oder ein Gate bekommt, beschreibt der Beitrag zur Content-Automatisierung mit KI: Es kommt darauf an, ob sich der Schritt rückgängig machen lässt.
Die Beispiele in der Tabelle sind allgemein gehalten. Legen Sie sie neben Ihren eigenen Ablauf und tragen Sie in die letzte Spalte Namen ein.
| Prüfobjekt | Wer erzeugt es | Entsteht vor oder nach dem Text-Gate | Prüfart | Wer prüft |
|---|---|---|---|---|
| Fließtext und Überschriften | Redaktion, mit oder ohne KI-Entwurf | vor | jede tragende Aussage gegen ihre Quelle halten | eine benannte Person mit Freigaberecht |
| Title-Element | Redaktion, SEO-Plugin oder Modell | je nach Ablauf | Abgleich mit dem freigegebenen Text, Länge prüfen | eine zweite Person oder ein unabhängiger Prüfer |
| Meta-Beschreibung | Redaktion, SEO-Plugin oder Modell | je nach Ablauf | Abgleich mit dem freigegebenen Text, jede Zahl und jede Zusage belegen | wie beim Title |
| Strukturierte Daten | CMS oder Plugin aus den Feldern des Beitrags | nach | Markup validieren und gegen den sichtbaren Inhalt halten | offen, das ist die Frage an Ihren Ablauf |
| Alt-Text | Redaktion oder Modell | nach | Abgleich mit Bild und Text, nur belegte Zahlen | wer das Bild vor sich hat |
Die dritte Spalte entscheidet. Felder mit „nach“ entstehen erst, wenn der Text schon freigegeben ist, und die Prüfung am Text-Gate erfasst sie deshalb nicht.
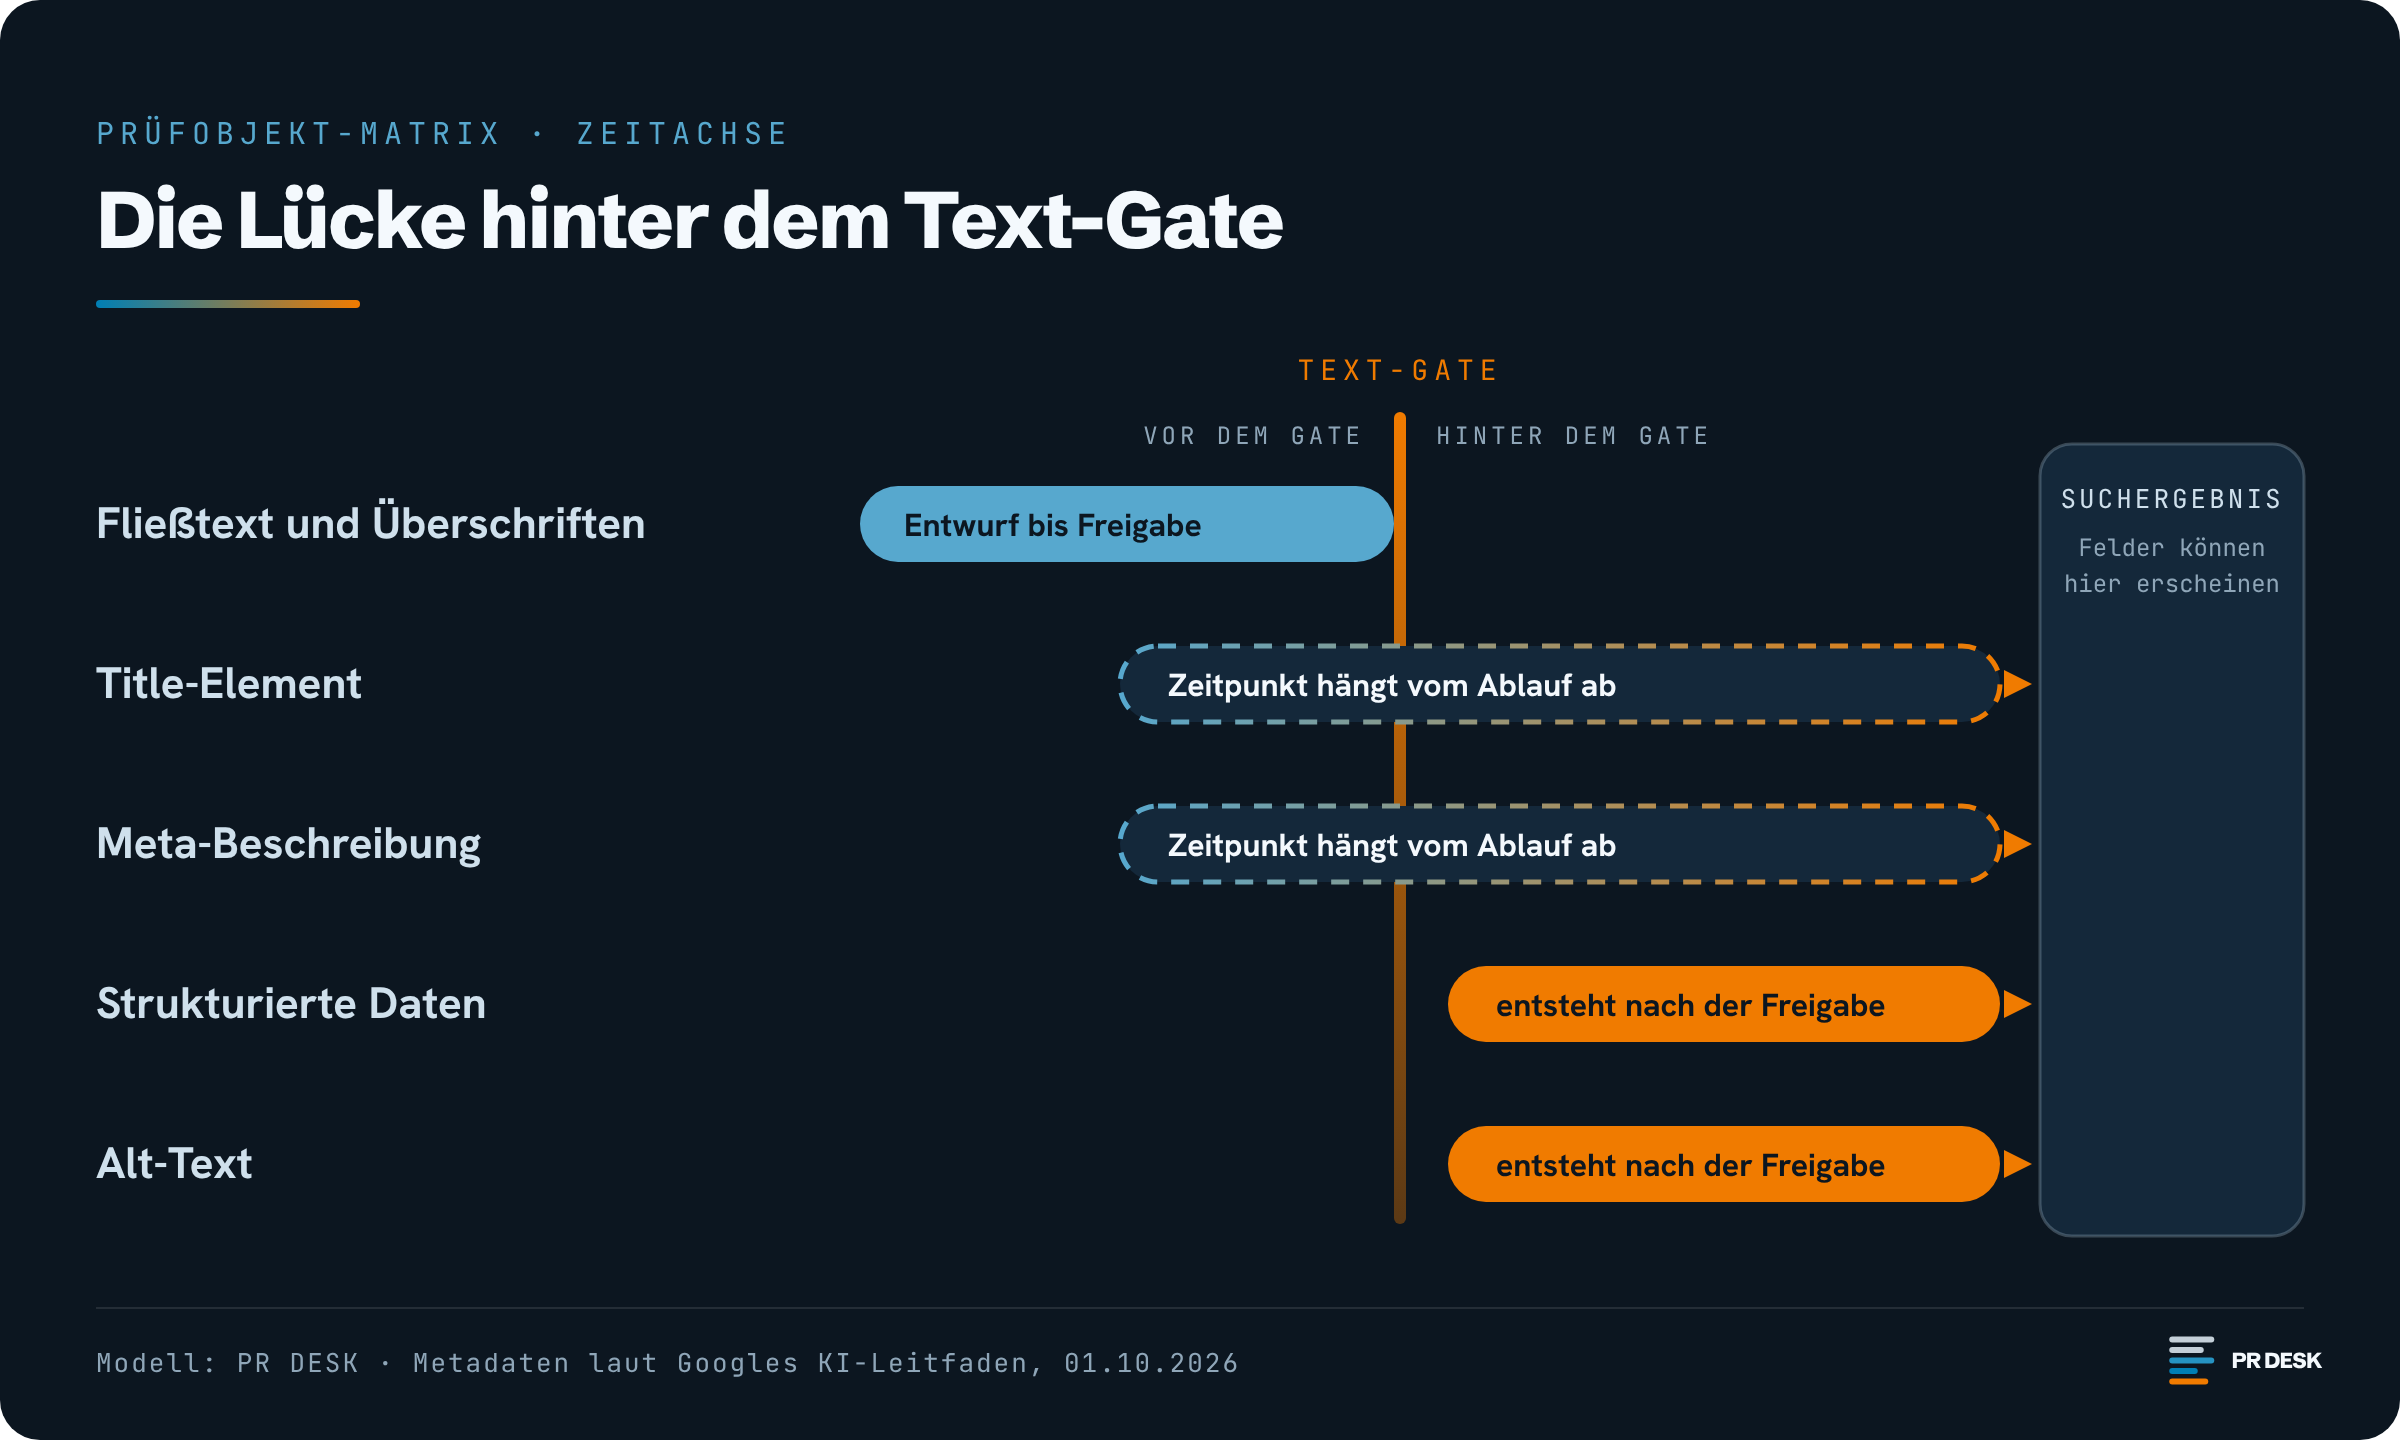
Bei PR DESK sieht das so aus: Den Fließtext prüft ein KI-Agent mit frischem Kontext, also ohne Einblick in die Entstehung des Entwurfs, Aussage für Aussage gegen die Quellen, jeder Durchgang mit einem neuen Prüfer. Die Freigabe gebe ich. SEO-Titel, Meta-Beschreibung und Alt-Text entstehen bei uns erst nach diesem Gate. Seit dem 2. Oktober 2026 gilt deshalb die Regel, dass ein eigener Prüfer mit frischem Kontext sie gegen den freigegebenen Text hält, bevor sie zur Freigabe gehen.
Bleibt die Frage vom Anfang, was „manuell“ jetzt eigentlich bedeutet. Google nennt die manuelle Prüfung entscheidend, erklärt das Wort im KI-Leitfaden aber nicht. Ich „interpretiere“ es so: Bevor ein prüfpflichtiges Objekt live geht, muss ein Mensch es freigeben. Die Prüfungsvorbereitung darf eine Maschine übernehmen. Bei uns sind das zwei getrennte Schritte. Den Abgleich mit den Quellen übernimmt ein Agent mit frischem Kontext, er liefert den Befund. Das Urteil, ob eine Aussage bleibt oder nicht, und die Freigabe liegen bei Menschen. Das ist die Lesart von PR DESK. Google gibt sie in dieser Form nicht vor.
Meine Empfehlung: Prüfen Sie Title, Meta-Beschreibung und Alt-Text so, wie eine Redaktion Überschrift, Teaser und Bildunterschrift prüft. In meiner Zeit als Redakteur übernahm das nach der Freigabe des Haupttextes ein zweiter Redakteur, es galt verbindlich das Vier-Augen-Prinzip. Danach habe ich noch einmal alles komplett Korrektur gelesen. Ein benannter Prüfer je Objekt und ein zweiter Lesegang über alles: Diese Ordnung trägt auch dann, wenn der erste Entwurf von einer Maschine kommt.
Warum Title, Meta und Alt-Text ein eigenes Faktencheck-Gate brauchen
Ein Gate prüft, was ihm vorliegt. Das Problem: Entsteht die Meta-Beschreibung erst nach der Freigabe des Textes, hat sie am Text-Gate kein Prüfer gesehen. Die Freigabe des Textes deckt sie nicht ab, auch wenn sie aus demselben Text gespeist wird. Verdichtet ein Plugin oder ein Modell den freigegebenen Text zur Meta-Beschreibung, kann beim Kürzen eine Einschränkung wegfallen. Ein Modell kann dabei sogar eine Zahl hinzufügen, die der Text nicht trägt.
Warum ist das wichtig? Weil diese Felder in Ihrem Schaufenster ganz vorne stehen. Google hebt hervor, dass sie in den Suchergebnissen erscheinen können. Wer dort eine Zahl liest, die im Text gar nicht steht, entscheidet über den Klick auf Basis eines ungeprüften Satzes. Dann hat der Text einen Prüfer, und das Schaufenster dekoriert die Automatik, auch wenn sie einen Fehler produziert hat. Schön ist anders.
Bei strukturierten Daten kommt ein zweiter Mechanismus dazu. Ein Validator wie Googles Rich-Results-Test prüft die technische Gültigkeit des Markups. Den Inhalt erfasst er nur zum Teil. Google führt unter den häufigen Gründen, warum strukturierte Daten nicht als Element im Suchergebnis erscheinen, selbst diesen auf: „The structured data is incorrect in a way that the Rich Results Test was not able to catch.“ Eigene Übersetzung: Die strukturierten Daten sind auf eine Weise falsch, die der Rich-Results-Test nicht erkennen konnte. Ein grüner Haken im Test ist also noch kein geprüftes Markup.
Vier Qualitätsmerkmale aus den Rater Guidelines als Prüfraster
Zurück zu den Search Quality Rater Guidelines vom Anfang. Ihren Maßstab für guten Inhalt greift Googles Leitfaden zu hilfreichen Inhalten auf, im Original „Creating helpful, reliable, people-first content“ (Stand 1. Oktober 2026). Er beschreibt die vier Merkmale, nach denen die Rater den Hauptinhalt einer Seite beurteilen: Effort, Originality, Talent or skill und Accuracy. Hauptinhalt ist für Google alles auf einer Webseite, was ihr direkt hilft, ihren Zweck zu erfüllen.
Ins Ranking gehen die Bewertungen der Rater laut Google nicht direkt ein: „Rater data is not used directly in our ranking algorithms.“ Eigene Übersetzung: Die Daten der Rater fließen nicht direkt in unsere Ranking-Algorithmen ein. Die Lektüre der Guidelines empfiehlt Google trotzdem. Sie könne helfen, Inhalte konzeptionell an den Signalen auszurichten, die Googles automatische Systeme für das Ranking nutzen (eigene Übersetzung, im Original: „help align it conceptually with the different signals that our automated systems use to rank content“). Für Content-Produzenten werden die vier Merkmale damit zu wichtigen Qualitäts-Leitplanken:
- Effort (Aufwand). Gemeint ist, wie viel menschliche Arbeit in einem Inhalt steckt. Der Leitfaden zu hilfreichen Inhalten nennt ein Gegenbeispiel: Wer mit generativer KI große Textmengen erzeugt, „without manual oversight or curation“, also ohne dass Menschen sie beaufsichtigen oder kuratieren, zeigt nach Googles Maßstab wenig bis gar keinen Aufwand. Ihre Frage: An welcher Stelle steckt menschliche Arbeit, die man dem Ergebnis ansieht?
- Originality. Ihre Frage: Steht im Beitrag etwas, das es auf keiner anderen Website gibt?
- Talent or skill. Ihre Frage: Würde jemand vom Fach den Text so unterschreiben, wie er ist?
- Accuracy. Für informative Seiten soll der Inhalt laut Google sachlich richtig sein. Zum Hauptinhalt zählt Google ausdrücklich auch „Page titles and headings“, die sichtbaren Titel und Überschriften. Ihre Frage: Ist auch die Überschrift gegen die Quelle gehalten oder nur der Absatz darunter?
Die letzte Frage führt zurück zur Matrix. Die sichtbare Überschrift zählt Google zum Hauptinhalt, das Title-Element zu den Metadaten. Geprüft gehören beide.
KI-Content? Offenlegen stand schon vor dem Update im KI-Leitfaden von Google
Neben dieser Prüfung nennt Googles KI-Leitfaden einen zweiten Teil: Kontext für Leser. Dieser Teil ist nicht neu, er stand schon in der deutschen Fassung des Leitfadens vom 31. Dezember 2025. Er gehört trotzdem in diesen Beitrag, weil er die Prüfung für Leser sichtbar macht. „Sharing information about how a piece of content was created can help give your readers more context“, heißt es im KI-Leitfaden. Eigene Übersetzung: Informationen darüber, wie ein Inhalt entstanden ist, können Ihren Lesern mehr Kontext geben. Dazu stellt auch ein zweites Google-Dokument eine Frage, der Leitfaden zu hilfreichen Inhalten. Sie lautet sinngemäß: Können Besucher den Einsatz von Automatisierung einschließlich KI erkennen, durch Offenlegung oder auf anderem Weg? Auch diese Frage stand schon in der deutschen Fassung dieses Leitfadens vom 18. Dezember 2025.
Für Bilder nennt Google einen technischen Weg. Wer Inhalte automatisch erzeugt, soll laut Google erwägen, Angaben zur Entstehung zu ergänzen, etwa über Bildmetadaten. Googles Seite zu Bildmetadaten nennt dafür IPTC-Metadaten mit dem Feld Digital Source Type, unter anderem mit dem Wert trainedAlgorithmicMedia für Bilder, die ein trainiertes Modell erzeugt hat. IPTC-Metadaten stecken direkt in der Bilddatei. Für Produktdaten im Google Merchant Center ist das Pflicht: Laut dessen Richtlinie zu KI-generierten Inhalten müssen KI-generierte Bilder diese Metadaten tragen. Wer KI-Bilder einsetzt, hat damit ein sechstes Prüfobjekt, die Metadaten im Bild selbst.
Dieser Beitrag trägt deshalb am Ende einen Hinweis, wie er entstanden ist: welche Arbeit die KI gemacht hat, wie viele Aussagen an festen Gates gegen ihre Quellen geprüft wurden und wer über den fertigen Text entschieden hat.
Praxistipp: Erst den Prüfer benennen, dann die KI ans Feld lassen
Für jedes Feld, das nach dem Text-Gate entsteht, gibt es zwei saubere Wege: Es bekommt einen benannten und verantwortlichen Prüfer, oder eine KI erzeugt es gar nicht erst. Ein automatisch befülltes Feld ohne Prüfer spart Arbeit beim Schreiben und verschiebt das Risiko an die Stelle, an der ein Fehler öffentlich wird. Anfangen können Sie in den Einstellungen Ihres CMS und Ihrer SEO-Plugins. Jede Funktion, die Title, Meta-Beschreibung, Alt-Text oder Markup automatisch füllt, gehört in Ihrer Matrix in die Spalte „Wer erzeugt es“. Steht in der letzten Spalte kein Name, schalten Sie die Funktion ab, bis einer drinsteht.
Dieser Beitrag ist mit KI entstanden: Sie hat recherchiert und den ersten Entwurf geschrieben. An festen Gates wurden 153 Aussagen gegen ihre Quellen geprüft, über den fertigen Text habe ich entschieden.
Quellen: Google Search Central: Google Search’s guidance on using generative AI content on your website, Stand 01.10.2026 · Deutsche Fassung, Stand 31.12.2025 · Google Search Central: Creating helpful, reliable, people-first content, Stand 01.10.2026 · Deutsche Fassung, Stand 18.12.2025 · Google Search Central: Latest documentation updates, Eintrag 1. Oktober 2026 · Google: Search Quality Rater Guidelines, im Dokument „General Guidelines“, Fassung vom 11.09.2025 (PDF) · Google Search Central: Spam policies for Google web search, Stand 28.08.2026 · Google Search Central: General Structured Data Guidelines, Stand 10.07.2026 · Google Search Central: Image metadata in Google Images, Stand 10.12.2025 · Google Merchant Center Help: AI-generated content, ohne Datumsangabe auf der Seite, gelesen 03.10.2026
Aus Ihrem Fachwissen wird ein Content-System. Lassen Sie uns klären, welches Thema Ihre erste Content Pipeline trägt. Erstgespräch vereinbaren →