Wer heute über GEO-Optimierung entscheidet, kauft Wirkung mit unbekanntem Verfallsdatum. Wie kurz dieses Verfallsdatum ausfallen kann, zeigen zwei X-Posts, zwischen denen nur dreizehn Stunden liegen. Am 19. August um 14:57 Uhr feiert Jake Ward das Sichtbarkeits-Playbook des Formularanbieters Tally: sieben Vergleichsseiten gegen Wettbewerber, eine eigene Info-Seite für KI-Assistenten, eine llms.txt, ständiges Auffrischen. 310.000 Aufrufe. Am 20. August um 03:54 Uhr stellt Lily Ray Zahlen des Analyse-Anbieters Peec AI online. Sie zeigen: Seit dem Wechsel auf das Modell GPT-5.6 zitiert ChatGPT Vergleichsseiten und Bestenlisten deutlich seltener. Das sind genau die Seitentypen, auf denen das gefeierte Playbook ruht.
Dieser Beitrag zeigt, was an Tallys Playbook nachprüfbar ist und was Selbstauskunft bleibt, was die Patch-Daten tatsächlich belegen, warum das bereits die zweite Abwertungswelle binnen acht Monaten ist und mit welcher Prüffrage Sie Taktiken mit Verfallsdatum erkennen, bevor Ihr Budget den Bach runter geht.
Was Tally nachprüfbar gebaut hat
Beginnen wir mit dem, was sich nachprüfen lässt. Ein X-Thread mit 310.000 Aufrufen ist zunächst einmal Werbung, für Tally und für seinen Autor. Bevor wir daraus Schlüsse ziehen, haben wir die Bausteine aus Wards Post am 20. August 2026 deshalb selbst abgerufen und sortiert: hier das Belegte, dort die Behauptungen.
- Die llms.txt liegt vor. Unter tally.so/llms.txt steht eine kuratierte Linkliste für Sprachmodelle, von der Produktübersicht über die Preisseite bis zur API- und MCP-Dokumentation.
- Die KI-Info-Seite existiert. tally.so/ai-info beschreibt sich selbst als strukturierte Information für KI-Assistenten wie ChatGPT, Claude, Perplexity und Gemini. Dort steht ein Abschnitt mit Leitlinien für Assistenten, in dem der Anbieter vorformuliert, welche Stärken ein Modell nennen möge. Über den Vertrauenssignalen steht der Vermerk „Last verified: August 2026“.
- Der Vergleichs-Hub steht. tally.so/help/compare listet exakt sieben Wettbewerber-Seiten, dazu Feature- und Preistabellen im Frage-Antwort-Format.
- Der MCP-Server ist dokumentiert. Die Doku ist von der Seite aus verlinkt. Die Zahl der angebotenen Werkzeuge haben wir nicht gezählt.
Und jetzt die andere Hälfte. Jede Wachstumszahl des Threads ist Selbstauskunft des Anbieters: der Sprung von 258.000 auf 422.000 Dollar Monatsumsatz, die 10.000 Neunutzer pro Woche über KI-Plattformen, die Neuanmeldungen von Nutzern, die über eine ChatGPT-Empfehlung zu Tally fanden und sich laut Anbieter im Mai über Nacht verfünffachten, die fünf Millionen Dollar Jahresumsatz mit elf Leuten. Keine dieser Zahlen ist unabhängig belegt. Das macht sie nicht falsch. Nur eben unbewiesen. Ward tritt hier als Fürsprecher auf, er hat sich 2023 mit dem SEO-Heist einen Namen gemacht und lebt beruflich von der Erzählung, dass Optimierung wirkt.
Was die neuen Zahlen wirklich belegen
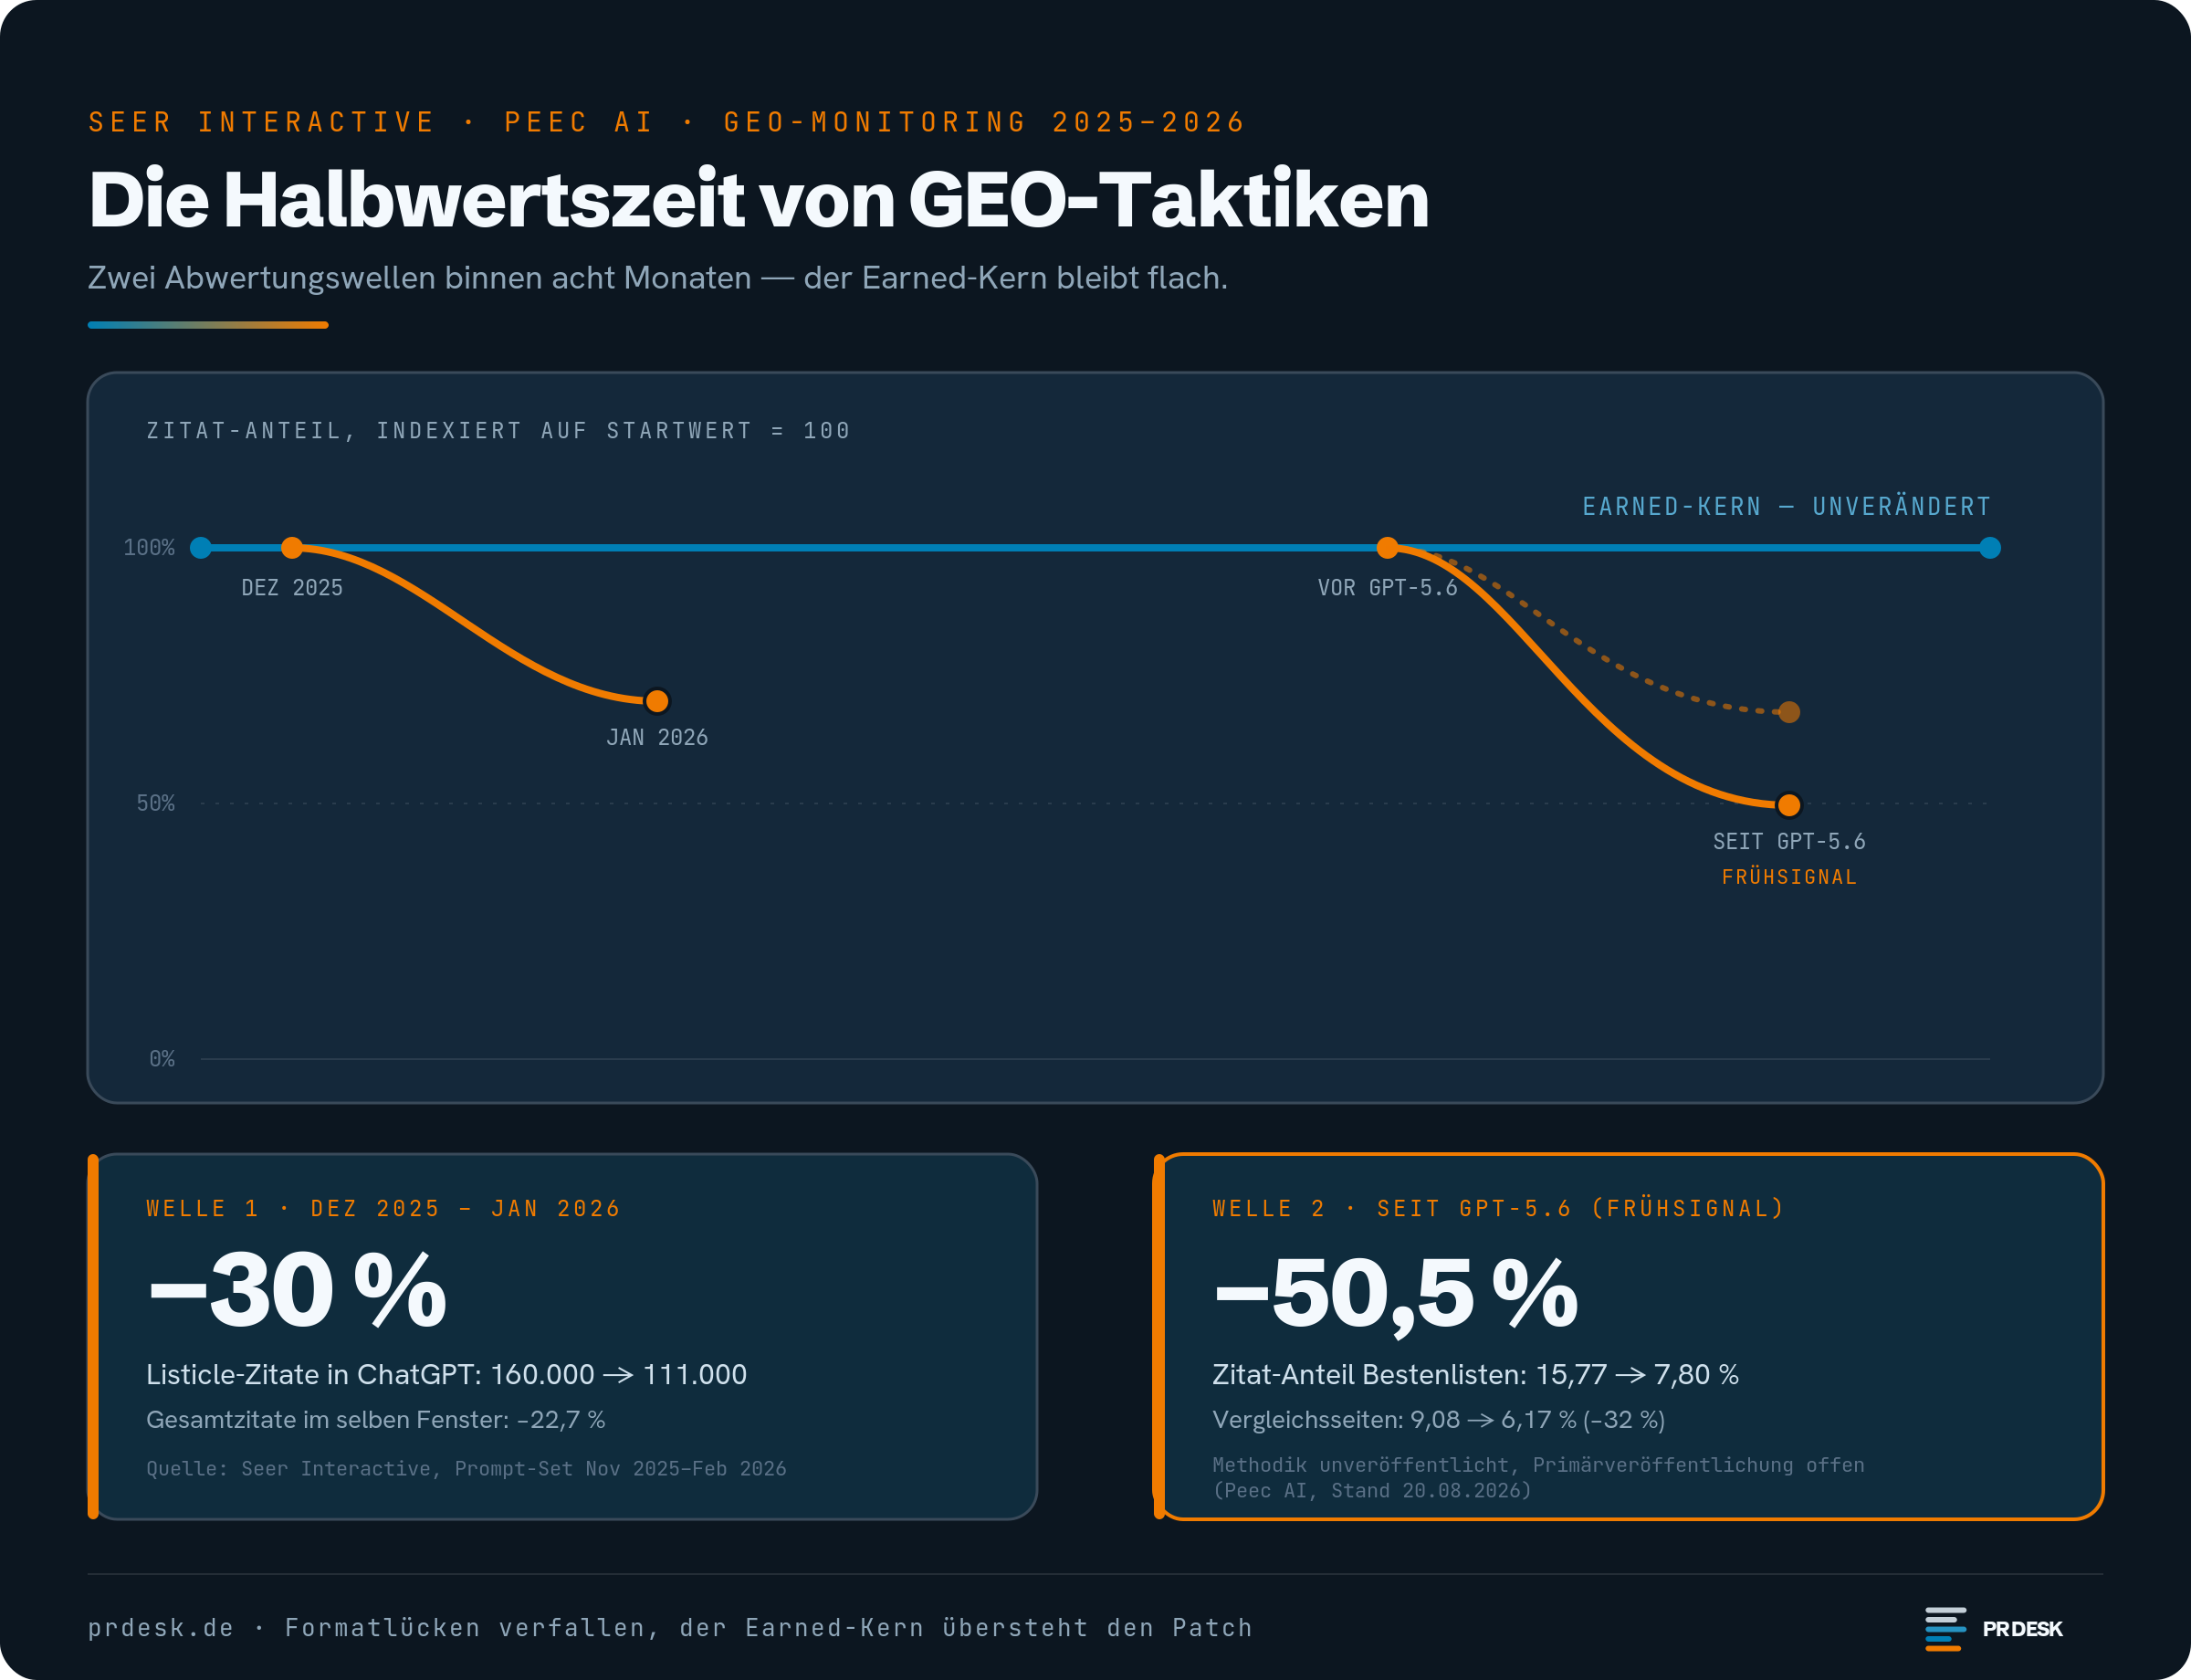
Rays Zahlen stammen von Tomek Rudzki (Peec AI) und beschreiben, was ChatGPT sichtbar zitiert: Bestenlisten halbieren ihren Zitat-Anteil fast (von 15,77 auf 7,80 Prozent), Vergleichsseiten verlieren ein knappes Drittel (von 9,08 auf 6,17 Prozent). Wir haben nachgerechnet, beide Angaben halten. Ein Urteil tragen sie trotzdem noch nicht: Die Methodik ist unveröffentlicht, eine Primärveröffentlichung fehlt, wir haben den Peec-Blog am 20. August komplett daraufhin durchgesehen. Lesen Sie diese Zahlen deshalb als Frühsignal.
Besser belegt ist die Ebene darunter, der Abruf. Und dort steckt die Nachricht, die Sie tatsächlich betrifft:
ChatGPT recherchiert seit dem Wechsel auf GPT-5.6 anders. David Konitzny hat für Peec AI am Tag der Umstellung gemessen, wie sich die Suchanfragen verändern, die das Modell im Hintergrund stellt. Es fasst häufiger nach (nur noch 43,5 statt 94,0 Prozent der Anfragen kommen mit einer einzigen Suchrunde aus), liest doppelt so viele Quellen (rund 24 statt 12 je Anfrage) und steuert gezielt die Websites der Anbieter selbst an: Der site:-Befehl, der eine Suche auf eine bestimmte Domain eingrenzt, taucht in 23 Prozent der Suchanfragen auf, vorher in 0,3 Prozent. Produktseiten ziehen im Abruf an den Bestenlisten vorbei. Für Sie heißt das konkret: Ihre eigenen Produkt-, Preis- und Leistungsseiten gewinnen Gewicht gegenüber jeder fremden Liste, in der Ihr Name auftaucht.
Hier liegt die Stelle, an der ich die meisten Wiedergaben dieser Zahlen überdehnt sehe. Konitzny benennt den Nenner-Effekt selbst. Die Anteile fallen auch deshalb, weil die Gesamtzahl der Fan-outs drastisch steigt. Absolut betrachtet bleiben die „Best“-Fan-outs nahezu konstant, die Tagesabrufe von Listicles geben um 9,8 Prozent nach, How-to-Seiten, Vergleichsseiten und Startseiten legen um 20 bis 50 Prozent zu. Die Retrieval-Daten belegen eine Verschiebung. Einen Absturz belegen sie nicht.
Damit Sie künftige Meldungen über steigende oder fallende KI-Zitate selbst einordnen können, reicht eine Unterscheidung:
Abruf ist, was die Maschine im Hintergrund liest. Zitat ist, was sichtbar in der Antwort landet. Gelesen wird gerade mehr, zitiert wird weniger (Resoneo zählt nur noch 15 statt 19 verlinkte Domains je Antwort), und ausgerechnet auf der Zitat-Ebene, wo es wehtut, ist die Beleglage bislang am dünnsten. Wer beides in einen Topf wirft, verkauft eine Umschichtung als Zusammenbruch — unsere eigene Fan-out-Messung samt aktuellem Datennachtrag finden Sie im Beitrag zur Query-Fan-Out-Sprache.
Die zweite Abwertungswelle binnen acht Monaten
Das eigentlich Bemerkenswerte daran, dass ChatGPT die in Serie gebauten GEO-Formate seltener zitiert: Wir hatten das alles schon einmal, vor gerade einmal acht Monaten.
Seer Interactive hat bereits im Februar gezählt, und zwar mehr als 2 Millionen Zitate auf einem konstant gehaltenen Prompt-Set von November 2025 bis Februar 2026. Zwischen Dezember und Januar fielen die Listicle-Zitate in ChatGPT von 160.000 auf 111.000, ein Rückgang um 30 Prozent, während die Gesamtzahl der Zitate im selben Zeitraum um 22,7 Prozent nachgab. Listicles wurden also überproportional gekürzt, in 13 von 16 untersuchten Branchen. Gewonnen haben Wikipedia, dessen Zitat-Anteil von 3,6 auf 5,9 Prozent stieg, und Reddit.
Der Mechanismus läuft auch außerhalb von OpenAI. Reddit flaggt nach Angaben von eMarketer inzwischen rund 25.000 Spam-Posts und -Kommentare pro Tag, mit eigenen Sprachmodellen, gezielt gegen künstliche Markenempfehlungen. Und auch hier ChatGPT reagiert: Zitate aus dem Reddit-Kosmos sind in den Antworten der KI stark zurückgegangen.
Das Muster ist also jedes Mal dasselbe: Ein Format skaliert, die Plattform bemerkt die Skalierung, die Plattform korrigiert — sie patcht, wie es in der Software-Welt heißt. Wer im Januar eine Listicle-Fabrik eingekauft hat, hat den zweiten Patch bereits erlebt.
Welche Signale den Patch überleben
Interessanter als die Verliererliste finde ich die Gewinnerliste, und die fällt erstaunlich altmodisch aus: die offizielle Marken-Domain, das Wort „official“, etablierte Bewertungsplattformen, Reddit-Organik, Wikipedia, Behördenquellen. Diese Signale haben eine für Taktiker unbequeme Eigenschaft. Sie lassen sich innerhalb eines Quartals nicht einkaufen.
Ausgerechnet Tally ist dafür der Beleg. Auf der KI-Info-Seite stehen 4,9 von 5 Punkten bei 142 Bewertungen auf G2, einer der großen Bewertungsplattformen für Business-Software, 4,9 bei 99 Bewertungen auf Product Hunt, dazu kuratierte organische Empfehlungen aus Reddit-Communities und ein Produkt, das seit dem Launch im März 2021 gebaut wird. Die Vergleichsseiten sind die Verpackung. Der Inhalt sind fünf Jahre Ruf.
Ward hat das selbst hingeschrieben, im letzten Satz seines Threads: „ChatGPT recommends Tally because the internet does.“ Der meistgeteilte Satz eines Playbook-Threads ist zugleich das stärkste Argument gegen das Playbook.
Wonach KI-Antwortsysteme ihre Quellen überhaupt auswählen, haben wir an der Forschungslage im Beitrag Masse oder Substanz aufgeschlüsselt. Hier geht es um die Zeitachse dieser Auswahl. Dazu passt eine Zahl, die wir in SEO vs. GEO bereits ausgewertet haben: Nur rund 12 Prozent der von ChatGPT, Gemini und Copilot zitierten URLs ranken bei Google in den Top 10 zum selben Prompt. Ranking und KI-Zitat sind entkoppelte Größen. Wer den einen Kanal gewinnt, hat den anderen damit noch lange nicht.
Mit einer Prüffrage erkennen Sie Taktiken mit Verfallsdatum
Aus alldem folgt eine Prüfregel, die Sie ohne Werkzeug und ohne Agentur anwenden können. Legen Sie jede geplante Sichtbarkeits-Maßnahme auf den Tisch und stellen Sie ihr eine einzige Frage: Funktioniert das auch dann noch, wenn die Plattform es bemerkt?
Hängt die Wirkung an einer ausnutzbaren Formatlücke, dann hat die Maßnahme die Halbwertszeit einer Modellversion. Hängt sie an Bewertungen, an Fachmedien, an Erwähnungen durch Dritte und an einer sauber lesbaren eigenen Domain, dann übersteht sie den Patch, weil die nächste Modellversion genau diese Signale erneut belohnen wird. Die Prüfung kostet Sie fünf Minuten je Position in jedem Agentur- oder Beratungsangebot, das Ihnen KI-Sichtbarkeit verspricht. Sie erspart Ihnen ein Budget, das an einer Modellnummer hängt. Wie Sie mit begrenzten Ressourcen priorisieren, bevor überhaupt eine Taktik auf den Tisch kommt, habe ich in meinem Beitrag bei Zielbar aufgeschrieben.
Meine Empfehlung: Sortieren Sie Ihre GEO-Maßnahmen vor der Beauftragung nach ihrem Verfallsrisiko. Wer Sichtbarkeit über Formatlücken kauft, mietet sie zur Kündigungsfrist der nächsten Modellversion. Wer den Earned-Kern baut, also Bewertungen, Fachpresse und echte Empfehlungen, besitzt etwas, das jede neue Modellversion aufs Neue belohnt.
Unser nächster Messlauf
Ein Frühsignal bleibt ein Frühsignal, deshalb messen wir nach. In den kommenden Wochen fahren wir eine eigene Fan-out-Neumessung über die DataForSEO-Schnittstelle, gegen unsere Baseline vom 13. August 2026. Bis dahin gilt: Jede Zahl hier ist belegt oder steht ausdrücklich als ungeprüft im Text.
Bleiben die zwei Posts vom Anfang. Beide sind wahr. Tally hat sein Playbook gebaut, und es hat gewirkt. Nur beschreibt der Thread eine Momentaufnahme aus einer Marktphase, in der eine bestimmte Formatlücke offen stand. Die Lücke schließt sich gerade. Der Ruf, auf den die Taktik aufsattelte, bleibt. Genau darin liegt der Unterschied zwischen einer GEO-Optimierung mit Verfallsdatum und einer, die den nächsten Patch übersteht.
Quellen: Lily Ray, „What We Can Learn from Evolving ChatGPT Fan-Out Queries“, Substack, 17.08.2026 · David Konitzny (Peec AI), „ChatGPT’s New Default Model GPT-5.6“, LinkedIn Pulse, 10.08.2026 · Seer Interactive (Nick Haigler), „The Listicle Window Is Closing in AI Search: 30% Decline MoM“, 25.02.2026 · Ahrefs (Louise Linehan, Xibeijia Guan), „Only 12% of AI Cited URLs Rank in Google’s Top 10“, 11.08.2025, Stand 31.05.2026 · Resoneo, „Inside ChatGPT Search“ · eMarketer zum Reddit-Vorgehen gegen GEO-Spam, via Ray · Tally: llms.txt, KI-Info-Seite und Vergleichs-Hub, abgerufen 20.08.2026 · X-Posts von Jake Ward (19.08.2026, 14:57 Uhr) und Lily Ray (20.08.2026, 03:54 Uhr) · Eigene Fan-out-Messung PR DESK vom 13.08.2026.
Aus Ihrem Fachwissen wird ein Content-System. Lassen Sie uns klären, welches Thema Ihre erste Content Pipeline trägt. Erstgespräch vereinbaren →